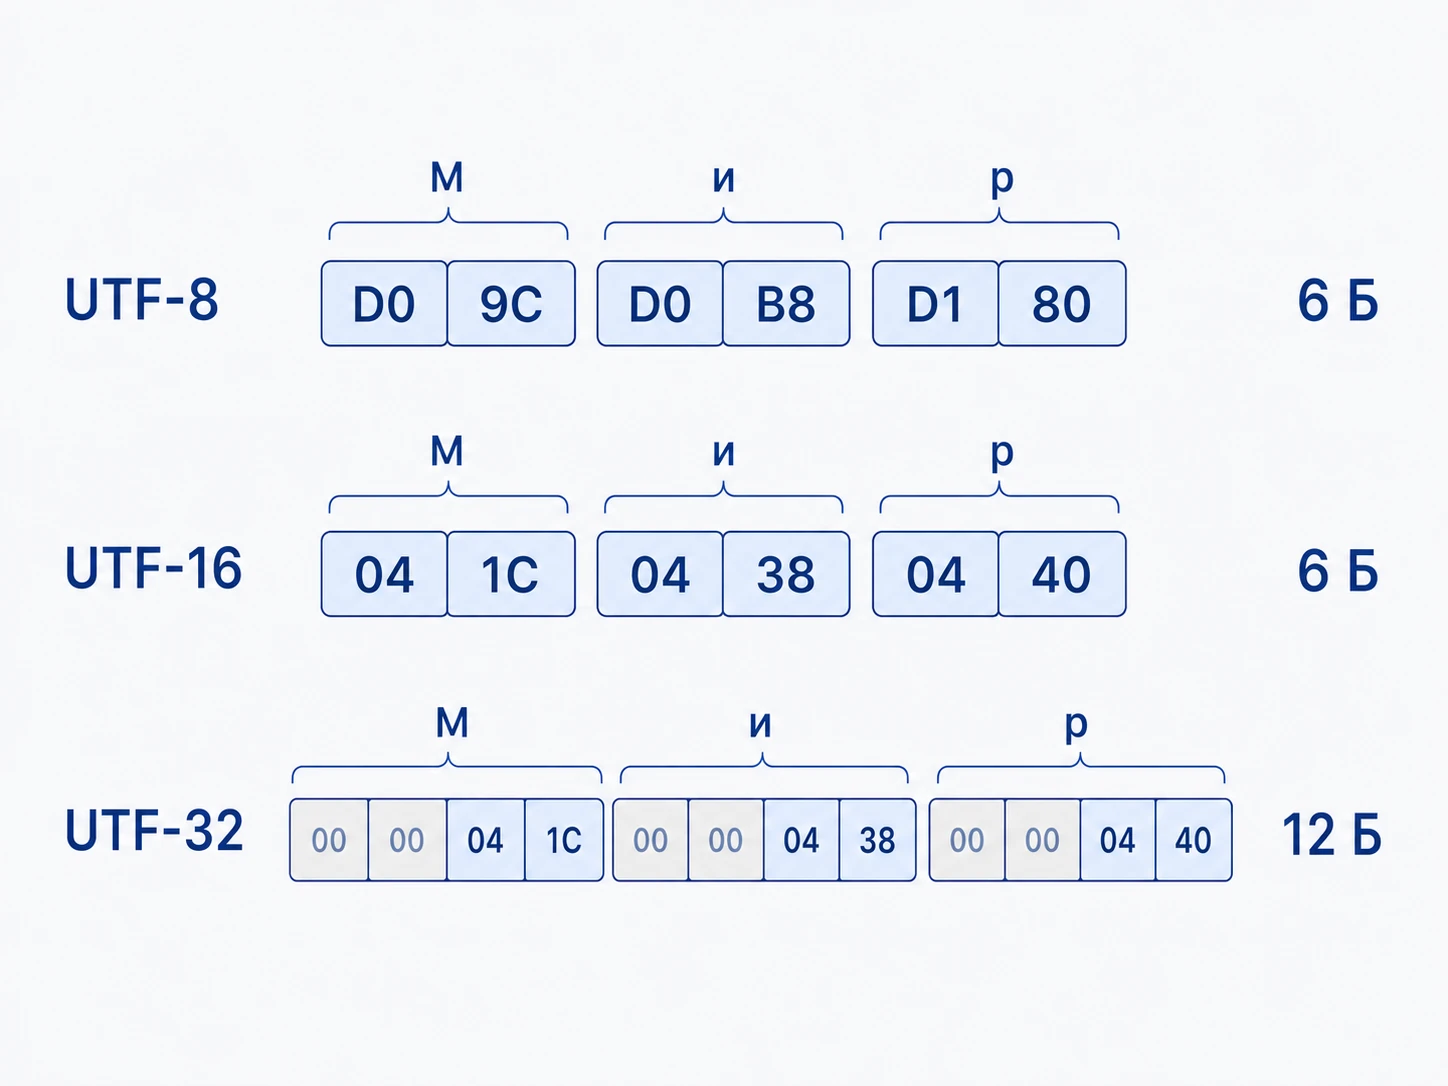
Откуда взялся третий формат, если UTF-8 так хорош? Из хронологии.
Когда Unicode только появился, в нём было 65 536 позиций и все верили, что этого хватит навсегда. Под эту веру и строили системы: Windows NT, Java, чуть позже JavaScript – все они внутри хранят строки как последовательность двухбайтовых ячеек. А в 1996 году, с версией Unicode 2.0, таблицу расширили до 17 плоскостей – и оказалось, что символ в две ячейки больше не влезает.
Разберёмся спокойно, потому что штука хитрая.
Как UTF-16 работает в простом случае. Файл читается не побайтово, а парами байтов. Каждая пара – одно число от 0 до 65 535, и это число прямо и есть номер символа. Такую пару называют ячейкой (по-английски code unit):
A  U+0041  →  ячейка 0x0041  →  байты 00 41
Ж  U+0416  →  ячейка 0x0416  →  байты 04 16
你 U+4F60  →  ячейка 0x4F60  →  байты 4F 60
Пока символ из основной плоскости, всё честно: один символ – одна ячейка – два байта, никакой возни с шаблонами, как в UTF-8. Ради этого формат и создавался.
В чём загвоздка. У 😀 номер U+1F600, то есть 128 512. В ячейку помещаются числа только до 65 535 – символ не влезает. Значит, придётся занять две ячейки. И тут же встаёт тот же вопрос, что и в UTF-8: программа читает ячейки подряд, как ей отличить одну ячейку-символ от половинки двухъячеечного символа?
Решение: дырка в таблице. В Unicode специально выкусили 2048 номеров – диапазон U+D800–U+DFFF – и объявили, что там никогда, ни при каких версиях стандарта не будет ни одного символа. Позиции пустуют навсегда, и именно в этом весь смысл: если ячейка содержит число из этой дырки, она заведомо не символ, а служебный сигнал «я половинка, ищи вторую рядом». Дырку поделили пополам:
- D800–DBFF – старшая половинка (1024 значения);
- DC00–DFFF – младшая половинка (1024 значения).
Такие половинки и называются суррогатами: суррогат – это заменитель, подделка. Сама по себе одна половинка не значит ничего, символ появляется только когда они встали в суррогатную пару.
Арифметика тут сходится идеально: $1024 \times 1024 = 1\,048\,576$ – ровно столько позиций во всех 16 верхних плоскостях. Каждому символу верхних плоскостей хватает своей пары, ни одна не лишняя.
Как символ разрезают на две половинки. Разберём 😀 по шагам:
- Берём номер и вычитаем 0x10000 – основную плоскость мы кодируем не парами, поэтому нумерацию начинаем заново:
0x1F600 - 0x10000 = 0xF600. Что осталось, гарантированно умещается в 20 битов.
- Записываем эти 20 битов:
0000111101 1000000000.
- Режем ровно пополам, по 10 битов: старшие
0000111101 = 61, младшие 1000000000 = 512.
- Каждую половинку кладём в свой диапазон, прибавляя его начало:
старшая:  0xD800 + 61  = 0xD83D
младшая:  0xDC00 + 512 = 0xDE00

итог: две ячейки D83D DE00  →  байты D8 3D DE 00
Почему по 10 битов – видно из размера половины дырки: 1024 значения это ровно $2^{10}$, а 10 + 10 = 20 битов, как раз сколько осталось после вычитания.
Почему это читается однозначно. Программа смотрит на очередную ячейку и сразу знает её роль по одному лишь значению:
| Значение ячейки |
Что это |
| меньше D800 или больше DFFF |
обычный символ, его номер |
| D800–DBFF |
первая половина пары, следом обязана идти вторая |
| DC00–DFFF |
вторая половина пары |
Это ровно та же идея, что и ведущий байт в UTF-8, только на уровне ячеек, а не байтов: по элементу ленты видно, сам он символ или часть чего-то большего.
Получился формат «2 или 4 байта»: вроде бы переменной длины, но без совместимости с ASCII (A в UTF-16 – это два байта 00 41, и нулевой байт на месте) и с зависимостью от порядка байтов, а значит, снова с BOM или пометкой BE/LE. То есть все минусы UTF-32 при части плюсов UTF-8.
Практическое следствие видно и сегодня: в JavaScript выражение "😀".length даёт 2. Язык считает не символы, а ячейки, а эмодзи занимает суррогатную пару. Хуже того, строку можно случайно разрезать прямо между половинками – и вместо смайлика на экране окажется пустой прямоугольник: половина пары символом не является. В Python 3 такой проблемы нет: там строка – последовательность кодовых точек, поэтому len('😀') равно 1.
Соберём сравнение в таблицу:
|
UTF-8 |
UTF-16 |
UTF-32 |
| Байтов на символ |
1–4 |
2 или 4 |
4 |
| Совместим с ASCII |
да |
нет |
нет |
| Нужен BOM / порядок байтов |
нет |
да |
да |
| Обращение к символу по номеру |
нужен проход |
нужен проход |
сразу |
| Где встречается |
файлы, веб, Linux |
внутри Windows, Java, JS |
внутри программ, редко |